2. 그래픽 연산과 전력 효율에 집중한 케플러
엔비디아 (NVIDIA)는 페르미 (Fermi) 아키텍처에서 그래픽 연산과 GPGPU의 두 분야를 모두 집중했고 AMD는 이후 GCN 아키텍처를 통해 페르미 아키텍처와 같은 방향성을 제시했다. 이에 따라 엔비디아는 이번에 어떤 방향성을 제공할지에 대해서는 확실하게 알려진 것은 없었으나 데스크탑 게임용에 보다 적합한 방향을 제시할 것으로 예상되었다.
엔비디아의 이러한 방향성은 이미 페르미 아키텍처 기반 지포스 GTX 560 (GF114)에서 시도된 것으로 새로울 것은 없지만, 그동안 상대적으로 밀려나 있던 게이밍 성능 향상과 전력 효율 문제에 집중한 것이 케플러 (Kepler) 아키텍처의 특징이라 할 수 있다.
게이밍 향상과 전력 효율에 집중한 케플러 (Kepler)
엔비디아 페르미 아키텍처는 그래픽 연산과 GPGPU 모두를 일정 수준 이상의 성능을 내주도록 개발했고 실제로 각 분야에서 높은 성능을 내줬다. 그러나 이로 인해 거대 다이 사이즈를 피하기 어려웠고 작은 다이 사이즈로 게이밍 성능에 집중한 AMD의 GPU 아키텍처보다 와트당 성능이나 전력 효율면에서 불리했다.
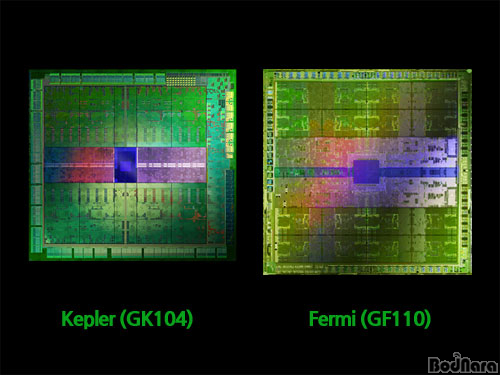
[언코어가 거대한 페르미 (Fermi)/ 간략해진 케플러 (Kepler)]
케플러는 페르미와 달리 실질적인 그래픽연산 효율과 성능에 집중한 페르미 아키텍처의 완성판으로 정의할 수 있다. 케플러의 이와 같은 전환은 양쪽 모두를 고려한 페르미 아키텍처가 성능 등에서 압도할 수 있었지만, 게임용 그래픽카드로 활용하기에는 GPGPU 연산을 위해 사용되는 불필요한 유닛들이 포함되어 비효율적이었다.
실제로 페르미에는 실질적인 연산 유닛인 쿠다 코어 (CUDA Cores) 보다는 이를 제어하는 명령 제어 유닛 (언코어)이 차지하는 비중이 상당히 높았으며, 이러한 부분은 게임용 그래픽카드로 활용하기에는 낭비되는 부분이 많다.
케플러는 이런 불필요한 제어 유닛을 다이어트하면서 게임용에 적합하도록 전환했다. 이러한 방향성은 AMD GPU 아키텍처 방향성과 유사하며, AMD는 GCN (Graphics Core Next) 아키텍처에서 GPGPU 연산 효율 및 유연성을 개선했지만, 여전히 페르미보다 트랜지스터 당 성능 효율이 높았다. 케플러 역시 AMD처럼 전환을 통해 스트림 프로세서 (SP, Streaming Processor)에 해당하는 쿠다 코어의 와트당 성능비를 최대 2배 이상 향상시켰다.
또한 이러한 변화와 함께 28nm 신공정 역시 페르미와 비교해 전력 효율을 크게 향상시키는데 중요한 역할을 해줬다. TSMC를 통해 제작되는 28nm 공정은 CPU에 사용되고 있는 HKMG (High-K Metal Gate)를 이용해 누설 전류 (Leakage)를 억제해 페르미보다 와트당 성능 및 전력 효율 개선에도 영향을 준다.
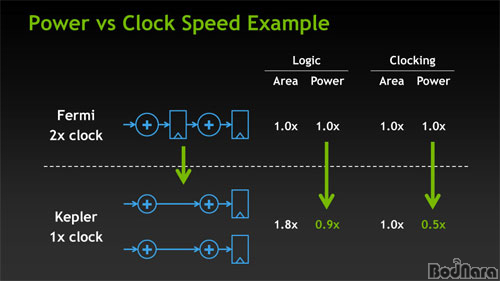
[코어 클럭과 동기화된 케플러의 쉐이더 클럭]
전력 효율 증대에는 구조가 바뀐 케플러의 클럭 설정에도 있다. 엔비디아는 페르미 제품군까지는 코어의 동작 클럭과 쉐이더 클럭을 서로 다르게 설정해 동작하도록 했다. 쉐이더 클럭은 코어 클럭의 2배로 동작했다. 코어와 쉐이더 클럭의 차이는 성능 향상에 도움되는 측면도 있지만, 클럭 설정에 따른 제어 로직과 클럭의 영향으로 전력 소모가 증대되었다.
그러나 케플러는 AMD와 같이 코어와 쉐이더 클럭을 1:1로 동기화되도록 교체했고 이로 인한 제어 로직이나 클럭에 따른 전력 소모를 줄일 수 있게 되었다. 쿠다 코어 수와 쉐이더 클럭이 증가하면 그만큼 전력 효율이 떨어진다. 케플러는 코어와 쉐이더 클럭 동기화를 통해 3배 더 늘어난 쿠다 코어를 제공함에도 전력 효율을 높일 수 있게 되었다.
CPU에 보다 의존하는 소프트웨어 스케쥴링으로 전환
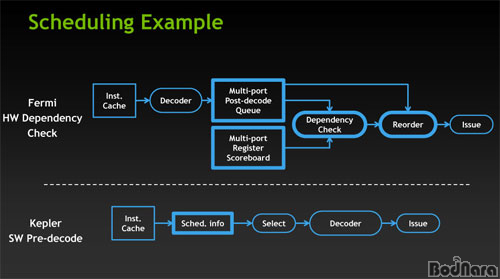
[명령 제어를 소프트웨어 (CPU)에 보다 의존]
AMD는 GCN (Graphics Core Next) 아키텍처를 라데온 HD 7000 시리즈에 도입하기 전까지 VLIW (Very Long Instruction Word) 아키텍처를 적용해왔으며, 이 방식은 CPU 의존도가 더 높은 소프트웨어 중심의 스케쥴링 방식을 이용했다. GCN 아키텍처에서는 보다 GPU의 하드웨에어 의존한 스케쥴링 방식으로 전환되었다.
엔비디아는 페르미까지 GPU 하드웨어에 의존하는 스케쥴링을 발전시켜왔고 이러한 이유로 AMD보다 명령 제어 유닛 수와 종류가 늘어나 다이 사이즈가 커져 실질적인 연산 유닛의 효율이 상대적으로 떨어졌다.
그러나 케플러는 CPU에 의존하는 스케쥴링 방식을 적용해 하드웨어의 복잡성을 더 낮추었다. 대신 이로 인해 드라이버와 CPU의 의존도가 높아졌다. 이는 CPU 부하로 인해 GPU 성능 저하가 발생할 수 있는 부분도 있으나 현재 CPU는 쿼드 코어 이상으로 진행 중이고 충분히 높은 성능을 제공하고 있기 때문에 CPU로 인한 병목현상은 크게 우려되지 않을 것으로 알려졌다.
폴리모프 엔진과 래스터 엔진, 테셀레이션 효율 개선
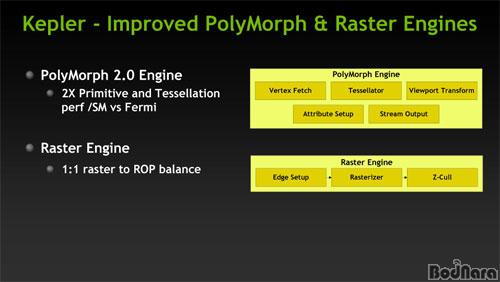
[엔진 수는 축소되나 효율을 개선한 케플러]
페르미 아키텍처는 DirectX 11과 테셀레이션 (Tessellation)의 전환을 역설할 만큼 엔비디아에서 공을 들였으며, 테셀레이터 수는 경쟁사를 앞도했고 이로 인해 실제로 DX11과 테셀레이션 성능에서 항상 AMD를 앞서왔다. 그러나, 이 부분 역시 다이 사이즈 증대와 전력의 비효율성을 늘리는 부분 중 하나였다.
케플러는 테셀레이터 (Tessellator) 등을 포함한 폴리모프 엔진 (PolyMorph Engine)을 2.0으로 업그레이드 했다. 특히 테셀레이션 처리 성능은 페르미 대비 클럭 당 대략 2배에 이른다. 지포스 GTX 680은 30% 높은 클럭 적용을 통해 테셀레이션 부하로 인한 전체 성능 향상을 이끌어낸다.
래스터 엔진 (Raster Engine)은 기존처럼 4GPC에 4개를 유지하는 Raster와 ROP를 1:1로 균형적으로 배치해 처리 효율을 개선한다.
메모리 컨트롤러 및 L2 캐쉬 감소, 효율은 개선
페르미는 8개의 메모리 컨트롤러와 L2 768KB 캐쉬 용량을 제공했고 8 ROP 유닛으로 구성되어 최대 48 ROPs와 384bit 메모리 인터페이스를 제공했다. 케플러 기반 지포스 GTX 680은 4개의 메모리 컨트롤러를 통해 L2 캐쉬 512KB를 제공하며, 32 ROPs와 256bit 메모리 인터페이스를 제공한다. 이로 인해 케플러는 고해상도와 AA/ AF가 결합되는 게이밍 환경에서는 384bit를 제공하는 라데온 HD 7900 시리즈와의 격차가 줄어든다.
케플러의 메모리는 페르미와 같이 GDDR5 SDRAM이 사용되나 지포스 GTX 580 (384bit 메모리 버스, 192.4GB/s)와 차이없는 192.26GB/s의 메모리 대역폭을 제공한다. 이는 6Gbps로 효율을 끌어올렸기 때문에 낮은 메모리 인터페이스에도 메모리 대역폭을 동일한 수준으로 만들 수 있었다.
L2 캐쉬 용량은 512KB로 줄었으나 케플러 기반 지포스 GTX 680의 L2 캐쉬 대역폭은 기존보다 73% 더 높아졌다. 또한 L2 캐쉬 입출력 역시 개선해 그래픽 연산과 GPGPU 연산의 효율을 높였다.
텍스처 유닛 증가 및 텍스처 처리 효율 개선
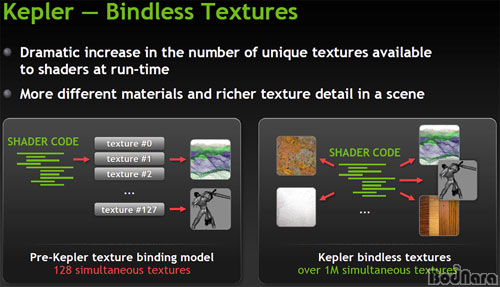
케플러는 텍스처 처리에서도 페르미에서 개선이 이루어졌다. 128개의 동시 처리가 제한된 페르미와 달리 케플러는 메모리를 직접 액세스해 1백만개 이상의 텍스처 동시 처리가 가능해졌으며, CPU 점유율 역시 기존보다 크게 줄였다. 실제 내장된 텍스처 유닛도 64개에서 128개로 2배가 늘어 텍스처 처리 능력도 개선되었다. |