| 이 기사의 의견 보기 |
|
|
| 한장수 / 02-09-08 23:59/
신고
|
|
|
오류지적: 전용T&L이 없다거나 또 기존의 T&L엔진보다 느리다고 한부분은 오류입니다. 아마 FIXED FUNCTION T&L과 Programable Shader의 역할을 잘 이해
|
|
|
|
|
| 한장수 / 02-09-09 0:03/
신고
|
|
|
못한부분이 있는줄 보입니다. 개념자체로 DX9에서 하드웨어 T&L엔진은 없어질수 없는것이고 기존T&L의 Fixed의 한정된기능에서 Programable로 발전한,속도도 향상된다는
|
|
|
|
|
| 한장수 / 02-09-09 0:05/
신고
|
|
|
식의 설명이 필요할걸로 생각합니다. 속도증가가 어디서 오는지 생각하면 글에서 왜 속도저하를 얘기하는지 엉뚱할뿐입니다. 글쓰기가 어렵군요.
|
|
|
|
|
| 한장수 / 02-09-09 0:09/
신고
|
|
|
나머지는 잘봤습니다. 수고하세요.
|
|
|
|
|
| 하얀나라 / 02-09-09 10:03/
신고
|
|
|
성능저하 부분은 기존T&L엔진으로 한사이클에 가능한것이 Vertex Shader에서오게 되면 여러차례의 사이클이 필요하게 됩니다. 이것은 고정기능의 T&L엔진과 프로그래밍된
|
|
|
|
|
| 하얀나라 / 02-09-09 10:04/
신고
|
|
|
Vertex Shader의 기능을 생각하면 쉽게 이해되며 이 때문에 기존 T&L엔진보다는 Vertex Shader에서 처리하게 되는것이 느리다고 생각됩니다. 하지만 이는 같은 유닛
|
|
|
|
|
| 하얀나라 / 02-09-09 10:05/
신고
|
|
|
수일때이며 지금과 같이 4개의 Vertex Shader유닛을 가지고 있음으로 이문제는 해결된것으로 생각되네여.. 글구 T&L엔진은 DX 7.0부터 나오고 있는것을 아시겠지만
|
|
|
|
|
| 하얀나라 / 02-09-09 10:06/
신고
|
|
|
지금의 8.1까지는 주가되어 Shader엔진과 공존했지만 이미 DX 9.0에는 포함되지 않을것이라는 소식을쉽게 접할수있네여.
|
|
|
|
|
| 하얀나라 / 02-09-09 10:11/
신고
|
|
|
하지만 저한테 DX9.0 API스펙에 대한 마소의 문서가 있는데 T&L엔진에 대한것은 찾아보기 힘드네여..
|
|
|
|
|
| 하얀나라 / 02-09-09 10:12/
신고
|
|
|
도통 API프로그래밍에 관한것이라서요..^^ 주로 Vertex & Pixel Shader 그리고 Tesellator 관한내용뿐입니다.
|
|
|
|
|
| jj / 02-09-09 13:09/
신고
|
|
|
메모리 대여폭? 메모리를 빌려주는게 아님.. 대역폭의 오타가 아닐찌..
|
|
|
|
|
| 한장수 / 02-09-09 14:34/
신고
|
|
|
R300이나 NV30이나 하드웨어 T&L은 없을수 없습니다. 또한 Shader라는말은 hardware shader 말을 포함합니다. 기존의 Fixed Function T&L엔진
|
|
|
|
|
| 한장수 / 02-09-09 14:37/
신고
|
|
|
에서 극히일부의 shader코드를 에뮬해서 software shader라는것도 가능은 합니다. 어느것이 빠르느냐, 당연히 하드웨어적Shader가 비교할수없이 빠른게 당연합니다.
|
|
|
|
|
| 한장수 / 02-09-09 14:41/
신고
|
|
|
DX상 T&L은 트랜스포밍&라이트닝 기능을 이르는 확장자인데 특정한 코어부분을 얘기하는게 아니라 코딩을 위한 명령어일뿐으로 보급형카드가 아닌한 없어진다는 개념은 없다고 이해하는게
|
|
|
|
|
| 한장수 / 02-09-09 14:43/
신고
|
|
|
좋겠습니다. 이걸 지원안한다면 요즘 3D카드라는 명함을 내밀지 못한다는 말입니다. 요점은 코어의 일부분을 얘기하는게 아닌만큼 없어졌다는 표현은 자제를..
|
|
|
|
|
| 한장수 / 02-09-09 14:51/
신고
|
|
|
인피닛엔진1에서 2로, 카리스마엔진에서 smartshader로, 점점 보완되고 향상된다는것이지 이전에 있던게 구멍나게 빠져나간다는게 아니라는 참고입니다.
|
|
|
|
|
| 한장수 / 02-09-09 14:54/
신고
|
|
|
그럼혹시 새DX에선 전부 프로그래머블shader로만 3D지시자를 연산하느냐 질문하면 우문입니다. 일부만 프로그래머블이고 아직 대부분은 Fixed Function코드들이니.
|
|
|
|
|
| 한장수 / 02-09-09 14:56/
신고
|
|
|
그럼..지나갑니다..
|
|
|
|
|
| 한장수 / 02-09-09 15:00/
신고
|
|
|
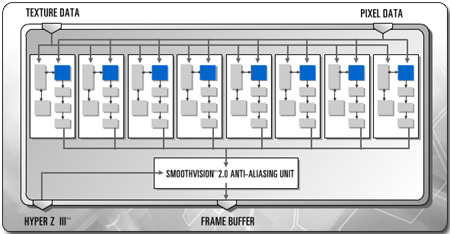
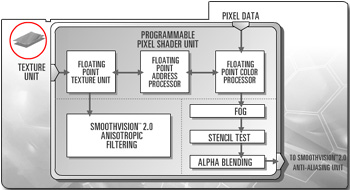
참고로 블록다이아그램에서 Pipeline과 파이프라인당 텍스쳐유닛(TMU)의 상관구조, 그리고 거기에 각각 PS와 VS가 어떤위치인지 구조를 잘 보면 상호관계가 좀더 다가올지..
|
|
|
|
|
| 한장수 / 02-09-09 15:01/
신고
|
|
|
말이길어졌네요. 계속수고하세요.
|
|
|
|
|
| 하얀나라 / 02-09-09 18:29/
신고
|
|
|
한장수님의 의견도 일리있는 말입니다. 하지만 제가 말하고자 했던것은 DX상에서 그래픽코어상에서 예기한것인데 잘못쓴것 같네여..제가 말하고자 한것은
|
|
|
|
|
| 하얀나라 / 02-09-09 18:31/
신고
|
|
|
DX상에 존재하는 명령어가 아닌 그래픽코어상의 엔진들을 예기한것입니다.
|
|
|
|
|
| 하얀나라 / 02-09-09 18:31/
신고
|
|
|
좋은지적 감사합니다.^^
|
|
|
|
|
| 한장수 / 02-09-10 1:14/
신고
|
|
|
이걸 자꾸 반복하는데 전용T&L엔진이 없다고 한다면 세계 최초의 발견/기사가 되는격이라고 말하겠습니다. 그럼..
|
|
|
|
|
| 한장수 / 02-09-10 1:54/
신고
|
|
|
같은비교선상에 있는게 아닌것을 같은것으로 상정해 놓고 비교하려니 일어나는 오해로 생각합니다. 리뷰어님 수고하시는데 딴지걸어 죄송합니다. .
|
|
|
|
|
| 한장수 / 02-09-10 2:01/
신고
|
|
|
언제부턴가 국내커뮤니티 일부유저 사이에서 T&L이 없다느니 얘기가 돌아다니길래 출처를 탐구해보니 여기까지 오게되서 말이 길어졌습니다. 오류가 진실로 변화되는건 순식간이더군요.
|
|
|
|
|
| 하얀나라 / 02-09-10 2:57/
신고
|
|
|
이거 계속 답변을 달게 되네여.^^ 이 문제가 세계 최초의 발견이 된다면 상당히 기쁘겠지만 아직 영어권 하드웨어 사이트에서는 DX9.0에 대한 정보가 나오고 있지 않습니다.
|
|
|
|
|
| 하얀나라 / 02-09-10 2:59/
신고
|
|
|
저두 이글을 작성하기 위해 정보를 수집하다 보니 DX9.0에 대한 칼럼등을 접하게 되어서 정보를 얻었는데 한장수님도 그쪽을 먼저 보셔야 할것같네여.
|
|
|
|
|
| 하얀나라 / 02-09-10 3:00/
신고
|
|
|
Impress PcWatch중에 주간해외뉴스란을 보시면 DX9.0에 대한 많은 정보가 올라오고 있습니다. 물론 T&L엔진에 대한것도 있고요..뭐 거의 칩제조사의 인터뷰를 바탕으로
|
|
|
|
|
| 하얀나라 / 02-09-10 3:02/
신고
|
|
|
작성되어있습니다. 아참 그리고 저희 뉴스란에 Impress PcWatch에 올라온 DX9.0에 관한 뉴스도 있으니 참고하시길바랍니다.
|
|
|
|
|
| 한장수 / 02-09-10 5:11/
신고
|
|
|
했던말 다시 반복하기가 귀찮네요. 말을 너무 돌려하려다보니 제대로 전달하기가 힘들고..그냥 넘어가겠습니다.
|
|
|
|
|
| 한장수 / 02-09-10 8:29/
신고
|
|
|
외국에선 들어볼수없는 독창적인 설명/분석.., 반어법입니다. 의욕이 앞선건지..
|
|
|
|
|
| 이호성 / 02-09-10 14:05/
신고
|
|
|
음. 저도 Impress PcWatch에 가봤는데 DX9에 대한 정보가 계속 올라오더군요.. 근데 장수님의 의견도 맞는거 같기두 하지만 그쪽의 글들을 보면 DX9.0세대의 GPU들
|
|
|
|
|
| 이호성 / 02-09-10 14:06/
신고
|
|
|
이 하드웨어 T&L엔진을 탑재하고 있지는 않는것으로 보입니다. 물론 R300에 그에 해당되는것으로 보이네요.. 뭐 있다면 ATI에서 지금까지 발전시켜온 T&L엔진에 대한 언급이 없
|
|
|
|
|
| 이호성 / 02-09-10 14:07/
신고
|
|
|
을리기 없겠죠^^.. 따라서 저는 하얀나라님의 말대로 Vertex Shader에서 T&L기능을 흡수했다는것이 맞을거 같네여.
|
|
|
|
|
| 이호성 / 02-09-10 14:09/
신고
|
|
|
궁금하신분들은 일한 번역기등을 이용해서 Impress PcWatch에 가보세요.. 주소가 어케되더라..http://www.watch.impress.co.jp/pc/
|
|
|
|
|
| 이호성 / 02-09-10 14:10/
신고
|
|
|
이거구요 Weekly란 제목을 글을 보면 나와있네여.. 뭐 번역기로 돌려보시면 바로 나옵니다.. 번역이 좀 이상해서 그렇지..ㅋㅋㅋ
|
|
|
|
|
| 한장수 / 02-09-10 23:26/
신고
|
|
|
오해하시는분들이 많은듯한데 반복합니다만 이제까지 말하는 하드웨어T&L엔진은 정식명칭이 아니라 so called라는것으로 하드웨어적으로 T&L을 할수있는 부분이 있느냐였습니다.
|
|
|
|
|
| 한장수 / 02-09-10 23:28/
신고
|
|
|
또 이제까지 그건 so called Fixed function T&L이란데서 vertex와 폴리곤을 연산하는 구조였는데 소스의 strip down,경량화, 재사용가능성을 높이기위해
|
|
|
|
|
| 한장수 / 02-09-10 23:31/
신고
|
|
|
프로그래머블, 즉 C언어와같이 단몇줄의 유연한 소스로 수십수백줄의 고정된소스와 같은 효과를 볼수있도록 shader라는게 도입되었는데 그 shader에서 인식가능한 코드명령어는
|
|
|
|
|
| 한장수 / 02-09-10 23:33/
신고
|
|
|
지금까지 아주 제한된숫자였고 앞으로도 static instruction의 지시자는 수백개로 한정되어있습니다. loop로 반복해서 늘어나는것이고. 그럼 이것으로 기존에 필드에서
|
|
|
|
|
| 한장수 / 02-09-10 23:34/
신고
|
|
|
사용되어왔고 지금현재 게임/어플에서 사용되는 Fixed코드들을 저 shader에서 대신 처리할수 있느냐, 불가능입니다.
|
|
|
|
|
| 한장수 / 02-09-10 23:36/
신고
|
|
|
shader가 필요한부분이 있고 장래발전이 그쪽으로 커가는건 맞는데 대체하는것은 아니라는 말이 됩니다. 지금 대체해버린다면 지금현재 나와있는 모든 게임들은 돌릴수 없다는 현상이
|
|
|
|
|
| 한장수 / 02-09-10 23:38/
신고
|
|
|
발생합니다. 지금유통되는 게임들 안해도 좋다고 하면, 또 앞으로도 게임할생각이 전혀 없다면 so called 하드웨어 T&L을 없애버려도 좋겠죠.
|
|
|
|
|
| 한장수 / 02-09-10 23:51/
신고
|
|
|
반대로 시각을 좀 돌려서 보면 T&L이 뭐냐는것부터 시작해도 좋습니다. 하드웨어T&L이 있느냐없느냐는 T&L이 뭐냐는것을 알면 좀더 다가오겠죠.
|
|
|
|
|
| 한장수 / 02-09-10 23:58/
신고
|
|
|
그리고 MS에서 T&L에 대해 앞으로 나오는 DX세대들에선 점점 Fixed Function methods on (primitive)vertex process 방식을 없애고 전부
|
|
|
|
|
| 한장수 / 02-09-11 0:03/
신고
|
|
|
신세대고급형 그래픽카드상에서는 Vertex shader process방식으로 전환해가는것은 맞습니다. 그럼 여기서 그T&L연산이 하드웨어T&L이냐 아니냐 묻는다면 당연히
|
|
|
|
|
| 한장수 / 02-09-11 0:06/
신고
|
|
|
하드웨어적T&L이지 그부분이 없어지거나 전용T&L이 없거나 에뮬레이트한다는것은 아니라는 말씀입니다. 그래서 속도가 느려진다는것도 오해이구요.
|
|
|
|
|
| 한장수 / 02-09-11 0:12/
신고
|
|
|
첨가로 vertex shader에도 한계가 있겠는데 geometry processing을 하는과정에서 원하는 vertex data에 transformation을 입히고,
|
|
|
|
|
| 한장수 / 02-09-11 0:17/
신고
|
|
|
vertex data에 lighting environment을 적용하고 원하는material models표면을 render하는데에는, 또 Static lighting이 아닌
|
|
|
|
|
| 한장수 / 02-09-11 0:21/
신고
|
|
|
dynamic lighting을 원한다면 수천개의 버텍스shader지시자가 필요하다는.. 그래서 각각회사들이 이에 총력전을 벌이고 있겠죠..미래의 얘기..
|
|
|
|
|
| 한장수 / 02-09-11 0:24/
신고
|
|
|
이얘기하다보니 퀘이크같은 게임들의 라이트맵이냐 버텍스맵이냐 하던 단어가 떠오르네요..그럼 수고를..
|
|
|
|
|
| 한장수 / 02-09-11 0:28/
신고
|
|
|
자꾸 글쓴이에게 죄송한데 한가지 더 지적해볼수 있는것이.. 텍스쳐유닛갯수에 대한것입니다.
|
|
|
|
|
| 한장수 / 02-09-11 0:29/
신고
|
|
|
이건 즉시수정이 필요할것 같은데 파이프라인당 텍스쳐유닛이 하나인, 하나로 줄어든것에 대한 설명이 잘못됐습니다.
|
|
|
|
|
| 한장수 / 02-09-11 0:30/
신고
|
|
|
9700에서 TMU가 1개인것은 ATi에서 극히 어쩔수없이 "살을내주고 뼈를보호한다"는 격언처럼 고육지책입니다. 파이프라인과 TMU 두개가 기본성능의 절대적인 지시자인데
|
|
|
|
|
| 한장수 / 02-09-11 0:32/
신고
|
|
|
희망대로라면 각2개씩의 TMU를 계획했겠지만 0.15미크론의 공정상, 1억개를 넘는 트랜지스터집적상, 그안에 PS와 VS, 듀얼램댁등 기타사양을 다 집어넣다보니 공간에 한계가 왔고
|
|
|
|
|
| 한장수 / 02-09-11 0:34/
신고
|
|
|
계산기를 두드려봐서 파이프라인수를 8개로 하는대신 TMU를 군살빼기해서 원하는 성능의 커트라인을 맞췄다고 보는게 보편적으로 생각할만 할겁니다. 이 TMU가 두개씩이었다면
|
|
|
|
|
| 한장수 / 02-09-11 0:36/
신고
|
|
|
지금성능보다 약일이십퍼센트는 더나왔을겁니다. 앞으로 나올 NV30은 0.13미크론공정이니 아마도 다집어넣고도 2개씩, 8x2의 구조로 R300과의 성능차이의 키포인트가 그것이 될것
|
|
|
|
|
| 한장수 / 02-09-11 0:37/
신고
|
|
|
입니다. 파이프라인수,각TMU수,메모리인터페이스(128비트인지256비트인지) 크게 이세가지만 키포인트만 결정되면 클럭에 맟춰 대략적인 성능예측을 할수 있겠죠..
|
|
|
|
|
| 한장수 / 02-09-11 0:43/
신고
|
|
|
자꾸 딴지건다고 미워하지말아주세요..
|
|
|
|
|
| 하얀나라 / 02-09-11 1:20/
신고
|
|
|
캬~ 한장수님 멋지네여. 저도 모르는점이 많지만 어느정도 이해했기에 글을 쓴것인데.. 아직도 님의 말에 이해가지 않는부분이 있지만 제가 미워하긴요..^^
|
|
|
|
|
| 하얀나라 / 02-09-11 1:23/
신고
|
|
|
앞으로도 자주 놀러오세여..^^ 근데 장수님 어떤일을 하고계신지 궁금하네여.^^
|
|
|
|
|
| 한장수 / 02-09-11 1:40/
신고
|
|
|
블록다이아그램에서 Vertex Processing Engine이 곧 Vertex Shader라고 대치시켜 생각한분들이 있으면 오해입니다.
|
|
|
|
|
| 한장수 / 02-09-11 1:45/
신고
|
|
|
전에도 하얀나라님글쓰시는건 잘봐왔습니다. 앞으로도 좋은글 부탁드립니다. 그럼.. 참..저는 백수라서 뭐 내세울게 없는..
|
|
|
|
|
| 아싸라비 / 02-09-14 9:13/
신고
|
|
|
으핫..백수님이 아니시라 분명 프리로 뛰시는 그래머이신듯..
|
|
|
|
|
| 아싸라비 / 02-09-14 9:14/
신고
|
|
|
이렇게 긴 리플들 첨봣습니다.여기서^^ 대단하시네요 두분 모두
|
|
|
|
|
| 한장수 / 02-09-15 14:08/
신고
|
|
|
쒸블놈 조또 모르는게 까부네
|
|
|
|
|
| 이호성 / 02-09-16 9:45/
신고
|
|
|
로그인 안하고 쓴거보니 윗분은 같은 분이 아닌거 같군요.. 지는 뭘 안다고.ㅡㅡㅋ
|
|
|
|
|
| 한장수 / 02-09-16 18:14/
신고
|
|
|
로긴안하는값을 이런것에서 받나보네요.. 아는건 별로 없지만 조금이라도 나눈다는 취지에서..
|
|
|
|
|
| 한장수 / 02-09-16 18:18/
신고
|
|
|
<a href=http://tech-report.com/reviews/2002q3/radeon-9700pro/index.x?pg=6 target=_blank>http://tech-report.com/reviews/2002q3/radeon-9700pro/index.x?pg=6</a> 중반에 보면 T&L언급이 좀 있는데 그렇게 이해를..
|
|
|
|
|
| 한장수 / 02-09-16 18:21/
신고
|
|
|
시끄럽게 느꼈다면 죄송하구요. 앞으론 더이상 이 한장수란 이름은 사용안하겠습니다. 꼭 할게있으면 실명게시판인만큼 실명으로 가야겠죠..
|
|
|
|
|
| 고정우 / 02-09-16 18:32/
신고
|
|
|
이상에서 느끼는것 하나..여기게시판은 덧글쓰는데 글자수가 많이 제한되어있다는게 약간은 읽기나 쓰기나 불편해보인다는것. 덧글에는 심각한 얘기 하지말자는 말이겠고.. 그럼 지나갑니다.
|
|
|
|
|
| 이호성 / 02-09-18 16:49/
신고
|
|
|
덧글이 짧긴하네여. 근데 여기만 그런건 아닌거 같은데.. 근데 한장수님.. 본명이 아니군요.. 누구실까? ^^ 근데 하드웨어랩에도 여기글이랑 비슷한 내용의 글이 있던데 거기도
|
|
|
|
|
| 이호성 / 02-09-18 16:49/
신고
|
|
|
T&L이 없어진다던데여.. 가보세여..
|
|
|
|
|
| 이호성 / 02-09-18 16:50/
신고
|
|
|
근데 거기글 저번에 하얀나라님이 위에서 말한 Impress PcWatch의 칼럼과 거의 같은내용이더군요..
|
|
|
|
|
| -.- / 02-09-18 17:32/
신고
|
|
|
데이트신청할겁니다.
|
|
|
|
|
| 고정우 / 02-10-03 15:24/
신고
|
|
|
T&L은 없어졌다는게 아니라, 과거fixed function pipeline이 사라지고 vertex shaders에서 T&L을 처리하는것으로 발전한것뿐입니다. 포인트가 좀 다르죠.
|
|
|
|
|
| j881019 (ID) / 03-06-26 18:12/
신고
|
|
과거에 비하면 비디오 계열의 발전은 실로 엄청납니다.
버추어 파이터 초기 때에도 얼마나 그 화면이 감동적이
었는지 상상이 가지만
그것은 -_- 나무깍이 인형 보다 더 해보이고
각진 그놈들이 얼마나 감격적이었는지
지금은 FSAA니 말도 않되는 각종 효과 들 주고 있습니다.
아마 5년안에 9700 정도의 성능도 저가형으로
밀리는 날이오면 정말로 허무할듯.
|
|
|