비주얼 컴퓨팅 분야의 세계적인 선도 기업인 엔비디아(www.nvidia.co.kr, CEO 젠슨황)는 미국 캘리포니아 새너제이에서 열리고 있는 세계 최대의 GPU 개발자 컨퍼런스 ‘GTC 2016’에서 가장 진보된 하이퍼스케일 데이터 센터 가속기인 ‘테슬라(Tesla) P100’ GPU를 출시했다.
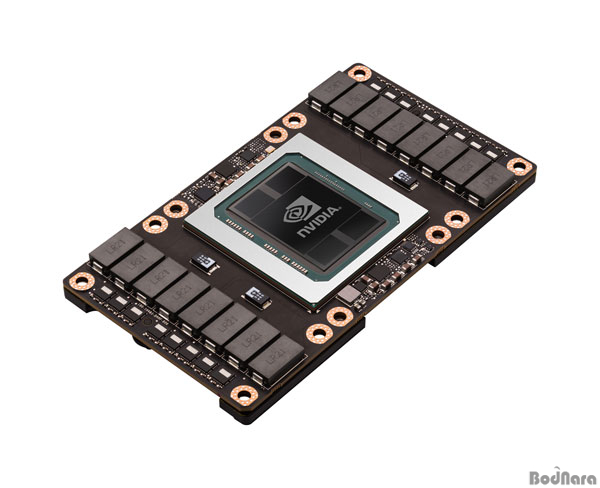
엔비디아의 차세대 ‘파스칼(Pascal)’ GPU 아키텍처를 기반으로 한 최신 가속 컴퓨팅 플랫폼 테슬라 P100은 수백 개의 CPU 노드를 합친 것과 동일한 수준의 성능을 자랑한다. 가장 심화된 연산 작업을 하는 애플리케이션을 위한 성능과 효율성을 제공하므로, 극대화된 노드와 빠른 속도를 필요로 하는 인공지능 및 과학 응용 분야에 적합하다.
테슬라 P100은 다음 기능을 기반으로 진보된 성능과 확장성, 프로그래밍 효율성을 제공한다.
혁신적인 성능 향상을 위한 엔비디아 파스칼(Pascal) 아키텍처
파스칼(Pascal) 기반 테슬라 P100은 이전 세대인 엔비디아 맥스웰(Maxwell) 기반 솔루션과 비교, 12배 향상된 뉴럴 네트워크 훈련 성능을 보인다.
애플리케이션 확장성 극대화를 위한 엔비디아 NV링크(NVLink)
엔비디아의 NV링크의 고속 GPU는 다중의 CPU에 걸쳐 애플리케이션을 확장하며, 현재 최고 수준의 솔루션과 비교했을 때 5배 가속화된 대역폭을 제공한다. 최대 8대의 테슬라 P100 GPU를 NV링크로 연결, 단일 노드에서 애플리케이션 성능을 최대화할 수 있다. 더 빠른 CPU와 GPU 간 정보 전송을 위해 IBM은 POWER8 CPU에 NV링크를 탑재했다.
최상의 에너지 효율을 위한 16nm 핀펫(FinFET)
16나노미터의 핀펫(FinFET, 3차원 입체 구조의 칩 설계 기술) 공정 기술의 153억 트랜지스터를 기반으로 한 파스칼 GPU 아키텍처는 현존하는 가장 큰 핀펫칩이다. 극한의 워크로드를 위해 가장 빠른 성능과 최상의 에너지 효율성을 제공한다.
빅데이터 작업을 위한 HBM2 탑재 CoWoS
파스칼 아키텍처는 효율성 극대화를 위해 프로세서와 데이터를 하나로 통합했다. HBM2(고대역폭 메모리)을 탑재한 CoWoS(Chip on Wafer on Substrate) 형태의 혁신적인 메모리 디자인을 통해, 맥스웰 아키텍쳐와 비교해 초당 720GB 또는 3배 이상 높은 메모리 대역폭 성능을 제공한다.
최고의 성능을 위한 새로운 AI 알고리즘
새로운 반정밀도의 명령은 딥러닝을 위해 21테라플롭스(teraflop, 1초에 1조회 연산) 이상의 성능을 제공한다. 배정밀도 및 단일 정밀도에서는 5에서 10 테라플롭스을 제공하는 첫 번째 가속기다.
테슬라(Tesla) P100 GPU 가속기는 다양한 고성능 슈퍼 컴퓨터(HPC)와 딥 러닝 애플리케이션에 혁신적인 성능을 제공한다. 그 예로 앰버(AMBER) 분자동력학 코드는 48 개 듀얼 소켓 CPU 서버 노드에서보다 테슬라 P100 GPU 기반 단일 서버 노드에서 더 빠르게 작동되며, 알렉스넷(AlexNet) 딥 뉴럴 네트워크 훈련에는 250 개의 듀얼 소켓 CPU 서버 노드의 성능이 여덟 개의 테슬라(Tesla) P100 GPU로 가능하다. 일기 예보 애플리케이션인 코스모(COSMO)는 27대의 듀얼 소켓 CPU 서버보다 여덟 개의 테슬라(Tesla) P100 GPU에서 더 빠르게 구동된다.
존 켈리 3세 (John Kelly III)박사 겸 인지 솔루션 및 IBM 연구 수석 부사장은 “엔비디아의 GPU와 OpenPOWER 기술의 결합은 이미 인공지능 왓슨의 기술 습득 과정을 가속화하고 있다”며, “IBM의 파워(Power) 아키텍처와 엔비디아의 파스칼 아키텍처는 인지 워크로드 성능을 가속화하고 인공지능 업계를 선도 할 것”이라고 밝혔다.
젠슨 황(Jen-Hsun Huang) 엔비디아 CEO 겸 공동창립자는 “암 치료 방법을 찾고, 기후 변화를 이해하며, 차세대 인공지능을 제작하는 등 우리의 과학적이고 기술적인 도전은 거의 무한한 양의 컴퓨팅 성능을 필요로 한다“며, “성능과 효율성 등 모든 수준에서 혁신적으로 발전한 엔비디아의 파스칼 GPU 아키텍처는 혁신가들에게는 새로운 기회를 제공할 것”이라고 말했다.
엔비디아 SDK 업데이트
한편 엔비디아는 GPU 컴퓨팅을 위한 개발 플랫폼인 엔비디아 SDK(소프트웨어 개발 키트) 업데이트도 함께 발표했다. 이번 업데이트는 ‘엔비디아 CUDA® 8’를 포함하는 엔비디아 병렬 컴퓨팅 플랫폼의 최신 버전으로, 개발자가 통합 메모리와 NV링크를 포함하는 새로운 파스칼 기능에 직접 접근할 수 있도록 돕는다. 또한 새로운 그래픽 분석 라이브러리로 로봇 경로 계획, 사이버 보안, 물류 분석 등에 사용가능한 ‘nvGRAPH’를 포함, 빅 데이터 분석 영역에 GPU 가속의 사용을 확대한다.
딥 뉴럴 네트워크를 위한 라이브러리인 ‘cuDNN 버전5’는 파스칼 GPU의 지원을 포함한다. 영상과 순차적인 데이터 처리에 사용되는 반복 뉴럴 네트워크의 가속화를 가능하게 하며, 의료, 석유 및 가스업계 등을 위한 기능도 추가 향상했다. cuDNN는 구글의 텐서플로(TensorFlow), UC버클리의 카페(Caffe), 몬트리올 대학의 시애노(Theano), 뉴욕 대학의 토치(Torch) 등의 딥러닝 프레임워크를 가속화한다. 이는 아마존, 페이스북, 구글 등의 딥 러닝 솔루션이 더욱 강화되는 것을 뜻한다.
한편, 7일까지 개최되는 GTC(GPU Technology Conference)는 GPU 기술로 달성한 과학 및 산업 분야의 혁신 사례를 소개하는 가장 영향력 있는 국제행사다. 올해 GTC 2016에서는 가상현실 외에도 인공지능, 자율주행, 로봇공학, 슈퍼컴퓨터, 그래픽 디자인, 엔터테인먼트 등 GPU 컴퓨팅이 영향을 미치는 다양한 산업을 광범위하게 다룬 500개 이상의 세션을 선보이고 있다.
테슬라 P100 사양
테슬라 P100 사양은 다음과 같다.
엔비디아 GPU BOOST™ 기술 기반 5.3 테라플롭스 배정밀도 성능, 10.6 테라플롭스 단정밀도 성능과 21.2 테라플롭스 반정밀도 성능
초당 160GB 성능의 양방향 상호 연결 대역폭 (엔비디아 NV링크 사용)
CoWoS HBM2의 16GB 스택 메모리
CoWoS HBM2의 스택 메모리의 초당 720GB 메모리 대역폭
통합 메모리와 페이지 연결 엔진의 강화된 프로그램 처리 능력
안정성 향상을 위한 ECC 보안
가장 높은 데이터 센터 처리량과 안정성을 위한 서버 최적화
NVIDIA DGX-1™ 딥 러닝 시스템의 파스칼 기반 테슬라 P100 GPU 가속기 상용화 시점은 6월이며, 주요 서버 제조사에서의 출시 시기는 2017년 상반기이다. |